


สำหรับ Blog นี้ขอบคุณทาง vLLM Bangkok ที่แจกบัตรเข้าร่วมงานครับ เลยได้มาจด และเขียน blog recap ไว้ครับ เพราะส่วนตัวมี ลอง vLLM ยัง Windows + Docker นะ ยกตกลงกับน้องไม่ได้เรื่องเกมครับ 555
สถานที่จัดงานตึก MS Siam Tower ชั้น 31 เป็น บ SVOA (สมัยเด็กเคยซื้อ PC มาเล่นอยู่ ตอนนี้ไปเน้นสายองค์กร กับ Dealer และ ไกลนิดนึง เรียกว่าเดินทางไกลถ้าจากสายใต้ใหม่ นั่งรถขับตรงได้ แต่รถเมล์จะอ้อมนิดนึงแบบนั่ง 89 หรือมาท่าพระก่อน แล้วต่อสาย 205 (ป่ายน้ำเงินครับ)
ส่วนที่ผมจดสรุปมามีตามนี้ครับ
Opening & What’s Ray and vLLM + Serving a Frontier Open Model with Ray & vLLM
Speaker Natdhanai Praneenatthavee
📌Why Ray ?
- Open Source Python Script มาจัดการด้าน AI ที่ local ตอนที่เรา Scale จะไป Cluster / Kube ก็ไม่ต้องมาปรับอะไรเพิ่ม โดย Ray เข้ามา manage resource + กระจาย load งาน
- พัฒนาโดยทีมของ AnyScale อันนี้ Speaker บอกว่ามีคนไทยร่วมทำด้วยนะ
- Ray มี Component ต่างๆ
- Ray Data(Distributed Data Processing) Data Ingestion และทำ Data Pipeline สำหรับการ Train Model
- Ray Train(Distributed Training) ฝึก Deep Learning / Large Models / Reinforcement Learning (RL) ข้ามหลาย GPU หรือหลาย Node
- Ray Tune (Grid Search) - ทำ Hyperparameter Tuning เพื่อค้นหาค่าที่ดีที่สุด สำหรับแต่ละ Model
- Ray Serve (Model Serving / Inference) - รองรับ Auto-scaling + Smart Routing กระจาย Request ไปยัง GPU ที่ว่าง
- RLlib - Distributed Reinforcement Learning + Agent Training - Core Concepts - Actor (Worker) > Task (งานที่ทำ พวก Req) > Object (ผลที่ได้)

📌vLLM Open Source สำหรับ Model Serving / Inference เน้นส่วน LLM หลังทมีมาปรับจูนในแต่ละ Use Case โดยทำให้ใช้ Resource ให้คุ้มที่สุด

- Continuous Batching: เพิ่ม Throughput พยายามรวม Req + Queue
- PagedAttention: จอง KV Cache Memory ออกเป็น Block เล็กๆ (เช่น Block Size 256) แบบ OS เพื่อแก้ปัญหา Memory Fragmentation ใช้ Memory คุ้มค่า
- Prefix Caching: ทำการ Caching ค่า KV Cache ที่ซ้ำกัน ลดการคิดซ้ำ / Time to First Token / Memory
- PD Disaggregation: แยก Resource Prefill [Input Prompt]-Decode[สร้าง Token คำตอบ]
- Speculative Decoding: ใช้ Scheduling มาช่วยให้รองรับ
- Quantization: มีตัวที่ Run หลายค่าย ทำให้รองรับ Model หลากหลาย อันนี้เดว 2 Session มีมา Optimize กับ HW ตัวเองด้วย นอกจากนี้
ทำให้ตัว vLLM รองรับ Model แรกๆ ตั้งแต่ Day0 อย่าง DeepSeek-V4-Flash / MiniMax M3.1
vLLM (Engine) with Ray(Control + Scale)

- Req (OpenAI Compatible)
- Ray Select/Scale Replica - Smart Request / Strategy ตาม Parallelism (DP) และ Expert Parallelism (EP)
- vLLM รับงานไปทำต่อ ซึ่ง Ray แยก GPU สำหรับ Prefill [Input Prompt]-Decode[สร้าง Token คำตอบ] PD Disaggregation โดยใช้ KV Cache มา Transfer พวก NIXL/ Mooncake
- Token Stream
- Keep Alive - จัดการให้ และถ้าพัง เดว Retry ให้ จัดการ Health Cluster มาให้ นอกจากนี้มี Ray Dashboard ดูภาพรวมได้

แต่ละ Model มีท่าในการตจัดการต่างกันอย่าง DeepSeek-V4-Flash(MoE) ที่ใช้ทั้งท่า Quantization (FP4/FP8) + PagedAttention มาจัดการกรณี Long Context / PD Disaggregation / Dspark / และ Strategy เลือก Tensor ให้เหมาะ
| Strategy | For | Use Case |
|---|---|---|
| TP | Model - Dense / MoE HW - Single-Node (NVLink) | เน้นความเร็วสร้าง Token (Low Latency) |
| PP | Model - Large Dense / MoE HW - Multi-Node InfiniBand (น่าจะถูก) | หลายเครื่องทำงานร่วมกัน |
| EP / TEP | Model - MoE HW - Single / Multi-Node | เน้น Expert ของ MoE |
| DEP | Model - MoE HW - Multi-GPU / Multi-Node | เน้น Throughput รวม Multi Concurrent |
| DCP / CP | Model - Dense / MoE HW - Multi-GPU | Long-Context เอกสารยาวๆ / Long-Thinking (1M Tokens) |
งาน AI Inference ต้อง Tune ให้เหมาะ ตาม Use Case + Model + Concurrent Req + HW ที่มี เคส DeepSeek-V4-Flash เลือก TEP เพื่อให้ยัดลง 1 Node ได้ / PD Disaggregation / Context ( --kv-cache-dtype fp8 --block-size 256) ลองบนตัว DGX Station
📚Resource: Slide / Youtube
State of vLLM 2026
Speaker Paphanin Amnuaikitwanit
Model Open weight ปล่อยออกมา ทุก 10 วัน ความท้าทาย Inference Capacity / Cost / Privacy / Inference Workload / Finetune ปรับเข้าภาษา ซึ่งตัว vLLM จุดแข็งมี Contribute เยอะ HW + Model Team เข้ามาร่วมด้วย เลยทำให้รองรับ Day0
สำหรับ vLLM เองมีการปรับใน 3 ส่วนหลักๆ
📌Core Design
- Model Runner V2 - ย้ายงาน Bookkeeping (เช่น Tokenization processing) จากเดิมใช้ CPU ไปเป็น GPU (Triton Kernels) ทำให้ Throughput + ตัว Tok Per Sec ดีขึ้น
- Asynchronous Scheduling - ลดเวลา Idle CPU / GPU โดยการใส่งานลงไปในช่วงที่ว่าง
- Model State Abstraction - แยก Runtime ที่จัดการตามประเภท Model Standard LLM / Auto-regressive LLMs / Diffusion Models (Image Video) / Whisper (Sound) เป็นต้น โดยใช้ API เดิมอยู่ ทำให้ Optimize ได้ง่าย ดึงมาให้เหมาะกับงานมากขึ้น
- Python > Rust - ลด Startup Time / Memory footprint ทำให้รองรับ Concurrency ได้เพิ่มขึ้น
- Uniform Standard Attention - พวกทำมาตรฐานกลางการอ่าน KV Cache ของแต่ละโมเดลขึ้นมา ทำให้จากตัว KV Connector / KV Manager

📌Model Optimization

- GPU Kernel Fusion: รวมขั้นตอนการคำนวณ เช่น GEMM เข้ากับ All-reduce เพื่อลด Overhead ในการสื่อสาร
- Parallelism Strategy: Parallelism ถึง 7 แบบ อันนี้มีตารางสรุปในหัวข้อแรกนะ พวก TP / PP / EP / TEP / DEP / DCP / CP โดยเราต้องเลือกให้เหมาะกับ Model + ENV ที่ Run ลดปัญหาทำซ้ำ
- Speculative Decoding: สามารถเปิด-ปิดใช้งานได้ง่ายผ่าน Config โดยมีทั้งแบบ Eagle, Single MTP และ DFlash ช่วยเร่งความเร็วในการสร้าง Token
📌Agentic Workload
- Context Reuse สำหรับ Multi-step Agents - Reuse KV Cache ลด Compute เหมาะกับ GPU / Memory จำกัด
- Mooncake - Distributed Storage System สำหรับงาน Scheduling และ Data Transfer
- Session Aware Rounting - ให้ไปหา / Reuse KV Cache ที่ Worker เดิมลด Compute ที่ไม่จำเป็น
- Smart Cache Eviction - ลด Block ของ KV Cache ที่ไม่จำเป็นจาก PagedAttention แบ่งไว้ ทำให้ได้ Memory คืนมา
- Sparse Retention - เก็บเฉพาะ Context ที่จำเป็นเอาพวก Thinking ของ Turn ก่อนหน้านั้นออก หรือ เอาทดที่ Tool Call ข้อดีลด Memory แต่แลกด้วยว่าอาจจะ Compute เพิ่มเล็กน้อย

Future Roadmap - Granular Metrics (มาดูว่าช้าในไหน) / Expanded Hardware Support / New Model Paradigms (พวก Reinforcement Learning (RL) / Vision-Language-Native (VL))
📚Resource: Slide
Beyond text-to-video: Omni Context Generation in a 33B Model
Speaker Sattaya Singkul
📌MiniMax H3 = Video+Sound Editing Model ที่ตอนนี้ Rank สูงกว่า Gemini Omni Flash / HappyHorse1.0 / Wan2.7 / Seeddance 2.0 (ทำไมมีแต่ Model จีน)
📌ทำไม MiniMax H3 ถึงเก่ง

- การทำ Text-to-Video ในอดีตมักใช้โมเดลแยกกันประมาณ 4 ก้อน (Text-to-Video, Text-to-Speech, Lip-sync, Upscaler) - ส่งผลให้เกิดปัญหา Context หลุดหายแต่ละ Step
- ใช้ Unified Native Model ที่รวม Text, Image, Video และ Audio เข้าด้วยกันใน Model เดียว ซึ่งช่วยรักษาความสัมพันธ์ข้าม Modality (เช่น เสียง การขยับริมฝีปาก การเคลื่อนไหวของภาพ) ทำให้วิดีโอที่มีความยาว และสมจริงได้มากขึ้น โดยแบ่งการทำงาน 3 ส่วน
- Context Understanding (Context IR): แปลง Input หลากหลาย Modality ให้กลายเป็น Structure Context Representation
- Dense Generation: Video Gen 768p จาก 4 Step ใช้ Diffusion Transformer ย่อย 4 ขั้นตอน:
1. Encoding แปลง Input เป็น Embedding
2. Sequence Packing
3. Generation ~59,000 Token ผ่าน Diffusion 49 Steps เติมที่ละจุดในภาพ ต่างกับ LLM ต่อไปเรื่อยๆ
4. Decoding แปลงออกมาเป็น Video 768p
- High Resolution Regeneration: Upscale 768p > 2K
ตอนนี้เปิด Open Weight เฉพาะส่วน Dense Generation จะเรียกว่า H3 Base

สำหรับ Session นี้มาเล่า Model MiniMax H3 ต้องใช้ GPU 8 ใบ VRAM 128 GB ตัวใหญ่ด้วย / ใช้เวลานาน 82 วินาที Video Gen 10 วินาที พอใช้ Resource เยอะเวลา Scale มาจะยากด เพราะคนเดียวเล่นจองไป 128 GB
📌ทำอย่างไรถึงสามารถ Run บน GPU ใบเดียว 16 GB / Perf ดีด้วย
- ทำ Static Lookup Table สำหรับ MLP/ITS - โดยไปเจอว่า AdaLN MLP ใช้ 13B param ทำรอบเดียวด้วย ช่วยลดการใช้ Memory จาก 128 GB เหลือเพียง 42 GB
- เปลี่ยนรูปแบบ Tensor Serving - ปรับ Data Transfer ให้เข้ากับ Diffusion Architecture
- จากเดิม By Row (LLM)
- มาใช้ Ulysses Parallelism - ปรับการส่ง ฺBy Column ค่าปรับตามจำนวน GPU
ข้อดี Resource GPU ลดไป 37% - Scale Distribute ง่าย เวลาเพิ่ม แต่เอาเทคนิคใน vLLM อย่าง Layer-wise Offloading / Separate Encoders / Task Rouning T2VA / FL2VA / Ref2VA - Layer-wise Offloading / Separate Encoders - แยก Node encoder ซึ่งรันเฉพาะช่วงแรก ทำให้ utlize ดีขึ้น
- Knowledge Distillation (DMD2) - ลดคำนวณของ Diffusion จากเดิม 49 Steps เหลือเพียง 4 Steps ทำให้เวลาการรันลดลงจาก 56 วินาที เหลือเพียง 8.7 วินาที
ปล เลข 4 เป็น Magic Number สุ่ม แล้วลอง
ผลจาก ลดเวลาได้ เวลาดลง 82.2 วินาที (59k 49step) > 56.9 (4 Step) โดย Model นี้ https://huggingface.co/FastVideo/FastH3-Omni-Comfy
แต่มัน For 1 User นะ สำหรับ Scale จะเอา Ray มาช่วย จัดการ Queue > Preproces vLLM Ommi > Decoder
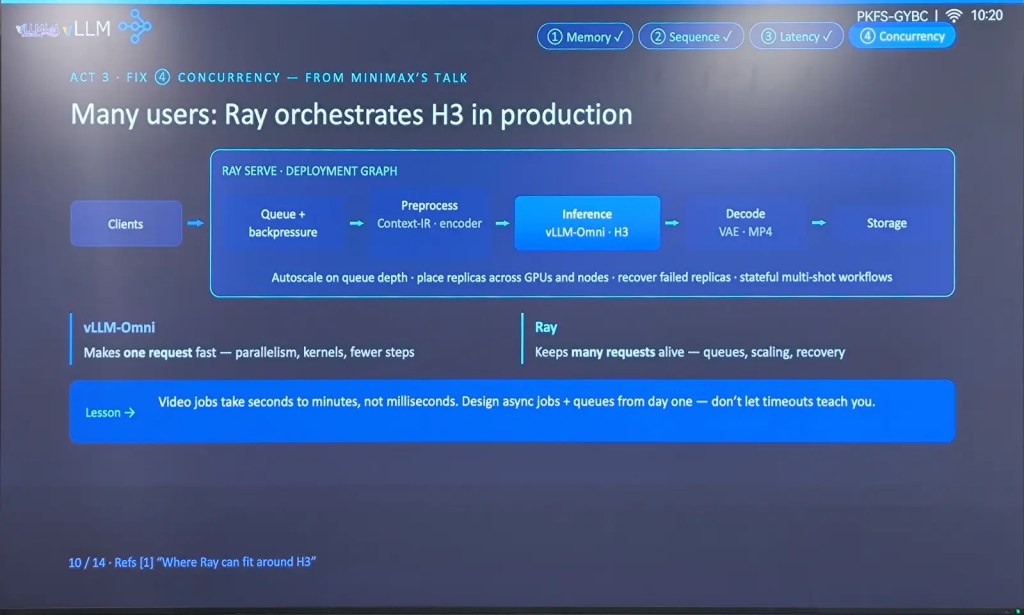
📚Resource: Slide
Accelerating Large Language Models: vLLM on TPUs
Speaker Kanin Kearpimy
ปัจจุบัน Data Center ประกอบด้วยกลุ่ม Compute หลายตัว CPU, GPU, TPU, NPU และ MPU ทำงานร่วมกัน และมีบริษัทที่ศึกษาพวกนี้มากกว่า 50 ที่ (ตอนแรกผมคิดว่า 20-30 เพราะไปส่องใน ALI มันนับได้ประมาณนั้นเลย)
How TPU work

ต้องมาเข้าใจการทำงานเดิมของ HW ก่อน ปกติมันเอาจากของจาก Memory พวกตัวแปรต่างๆ มาทดใน register ของ CPU (LOAD) และคำนวน เช่น คูณ และส่งผลลัพธ์กลับไป (Store) นึกถึง CP121 (LC-3) เลย เรียกมาน่าจะเกือบ 14-15 ปีแล้ว แล้วที่มันวิธีการคิดแต่ละแบบ


- SISD (Single Instuction Single Data) - ทำทีละ 1 ตัว ของ CPU ทำแบบนี้
- SIMD (Single Instuction Multiple Data) - ทำที่ละ Vector Load ข้อมูล พวก GPU/ CPU (AVX512 ใช้)
ปัญหาของ SISD / SIMD เกิด Idle Time มีการขอของจากแต่ละ Operatino เช่น LOAD ทำให้จบ ถึงทำ MULTIPLY ได้ เลยได้แบบต่อมา SIMT
- SIMT (Single Instuction Multiple Thread) - ใช้ Compute เล็กๆ มา เข้าถึง Shared Memory พร้อมกัน แล้วคำนวณ ได้ที่ละ Matrix เลยมี Idea เอา GPU มาต่อกัน แต่ยังมี Bottleneck Memory Bandwidth / Compute Idle ถ้าข้อมูลใหญ่มากๆ


เลยเป็นอีก Idea ของ TPU เอาข้อมูลมาจัดแบบ Tensor (Array ซ้อน Matrix) แล้วใช้ Systolic Array ซึ่งมันพยายามลดการเข้าถึง Memory ให้น้อยที่สุด ดีงมาแล้วหาทาง Reuse ในช่วยตอนคำนวณในส่วน Processing Elements (PE) ทำให้ประหยัดเวลาเมื่อทำงานขนาดใหญ่ และยาวๆอย่างเคส LLM ง
ตัวอย่าง MXU Matric Multiple Unit ลด Fetch / Store Step แต่ TPU มันงานเฉพาะทางเลยนะ
How vLLM Work
- Compute Bound: แก้ไขด้วย Continuous Batching เพื่อลดเวลาคอย (Idle Time) ของให้ประมวลผล
- Memory Bound: แก้ไขด้วย PagedAttention จัดการพื้นที่ KV Cache Memory ลดปัญหา Memory Fragmentation
TorchTPU (Programming TPU)


- เดิม เราเขียนผ่าน TorchAX ตอนนี้จะให้ไปใช้ TourchTPU ซึ่งปัญหาของ TorchAX มันจะไปเรียก JAX Idea แบบ Python ไปเรียก Code C++ มาทำงานผ่าน IRC ซึ่ง Debug หรือ Track ชื่องานยาก
- เลยเอา TorchTPU มัน Optimize มากับ TPU ลด Overhead ส่วนของ JAX
นอกจากนี้มีส่วน stablehlo ทำเป็นภาษากลางให้คนอื่นใช้ รวมถึงใช้กับ Graph IR แปลง Graph และ Optimize อย่าง Operation Fusion เพื่อลด Operation
สุดท้าย No Silver Bullet เลือกงานให้เหมาะสม CPU / GPU / TPU ตาม Use Case / vLLM มีแบบ TPU นะ
อันนี้อื่นๆ ตปท Agentic AI ไม่ใช่ Use Case Customer Facing / Employe Facing เพราะ User Data พวก PDPA มันแรงงง / คนสร้าง OpenRounter 3 Trillion ความยาก Rounting ยังไงให้ถูกที ถูก Context KV-เดิม
📚Resource: Slide
AMD and vLLM: What’s New
Speaker Passin Pornvoraphat
ตัว Community เข้า Support มากขึ้น พวก ROCm + vLLM (PR 1041 14.2% 172 Dev ) ที่สำคัญ เมื่อก่อนมันจะเน้นค่ายเขียว ตอนนี้ Trend ขาขึ้นด้วย โดน Top 10 มาจาก AMD และทาง AMD จัดคนเเข้ามาทำเลยนะ 5 คน

2026 จาก Fork > Upstream

- ทำให้เราได้ Feature ที่ Required HW AMD แบบทันที และสามารถ Switch ได้ HW อื่นๆได้สะดวกด้วย ลงยังไงตาม code เลย ROCm + UV
- CI ของ AMD vLLM เค้าปรับ Flow Release + Test ได้ดีขึ้น Coverage ขึ้น และคุณภาพคงเดิม รวมถึงเพิ่ม HW Support Test มากขึ้น AMD Instinct 5 MI250 / MI300x / MI325x / MI450 และมีพวก Gaming Card (NAVI) / APU ด้วย
- Day 0 สำหรับ Model ใหม่พวก DeepSeek Qwen GPT-OSS
รอบรับ Quark Checkpoint - ROCm via PIP + Requirement.txt lock version ได้
Tools: Kernel / AITER / ATOM / Quark / TraceLens / NIXL
- FlyDSL คุม Kernel via python
- AITER Lib รวม Kernels Build For AMD PyTorch DSL, Triton DSL
- ATOM ตัวทำ Scheduling / Batching ของ Request / บริหารจัดการ KV Cache แบบ TensorRT ของค่ายเขียว
แต่ถ้าเทียบกับค่ายเขียวหละเอาอะไรชนอะไร ตามรูปเลย

- Quark Tools ทำ Quantization และหา Check Point บน HuggingFace มาช่วย จะได้ไม่ทำซ้ำ
- TraceLens บอกว่าเราใช้ Resource ไปกับอะไร หรือ HOP ที่ได้แต่ละรอบเป็นยังไง
NSight ของ เขียว - NIXL เมื่อก่อน AMD ต้อง Fork มาเป็น RIXL แล้วแก้ตามตอนนี้รวม Repo แล้ว ของ HW AMD ใช้ทั้ง NIXL / RIXL ได้
vLLM บน NAVI (Gamming / Workstation Card) รองรับการลงได้มากขึ้น ตั้งแต่เครื่องเล็ก(Ryzen AI+APU / Ryzen AI Halo ชนกับ DGX) > Workstation (Radeon 7000 /9000 / Pro) > Server (Instinct) ไม่ต้องไป Customแยก
Repo แนะนำตามรูป

📚Resource: Slide
NVIDIA and vLLM Full-Stack Collaboration for DeepSeek and MiniMax Performance
Speaker Arisa Umparat
ถ้าแม้ว่าเราจะมี Model แบบ MoE (Mixed Of Expert) ที่มัน Active Parameter ตามจำนวนที่ใช้ ใน Expert ด้านนั้นๆแล้ว แต่เรายังพบว่ามันยังช้าอยู่ แม้ว่าจะเลือก Strategy แบบ TP / EP แล้ว
โดย Bottleneck ใน 4 Level: Kernel, Communication ข้าม GPU / การจัดการ Memory + HW และ การจัดการ Node (Orchestration) ซึ่งแต่ละ Level มีวิธีการจัดการต่างกันไป
Kernel (Model Kimi K3)
- ปัญหา: Kimi K3 มีทั้ง Shared Expert (ขนาดใหญ่ เช่น 7,000) และ Routed Experts (ขนาดเล็ก เช่น 3,000) ทำให้เกิดปัญหาขนาดไม่เท่ากัน เกิด Bottleneck ตอนส่งข้อมูลและคำนวณ ไอ้ 7000 / 3000 ผมเข้าใจว่าขนาด Vector นะ
- วิธีปรับ: Kernel Fusion รวมการคำนวณของ Shared Expert และ Routed Expert เข้าด้วยกันในขั้นตอนเดียว แล้วประมวลผลพร้อมกัน ลด Latency ลงได้ถึง 19.5% ช่วยเพิ่ม Throughput


Communication Level Optimization (Model MiniMax)
- ปัญหา: ข้อมูลมีขนาดเล็ก ถ้าพังจาก Section Beyond text-to-video: Omni Context Generation in a 33B Model เค้าปรับ Row เป็น Column ตามจำนวน GPU ข้อมูลเล็กลง แต่เสียเวลารวม Head All-Reduce (H-RS)
- วิธีปรับ: เปลี่ยนจาก Two-shot All-Reduce รวม 2 รอบ เป็น One-shot All-Reduce โดยดูจาก Batch Size น้อยกว่า 40 ให้สลับมาใช้ One-shot ทันที ซึ่งลด Latency ลงได้สูงสุดถึง 52% ผลลัพธ์ยัง OK


การจัดการ Memory + HW (Model DeepSeek R1)
- ปัญหา: Prefill (Compute-bound) และ Decode (Memory-bound) ใช้ Resource ต่างกัน จะคล้ายกับ Open Session
- วิธีปรับ:
- ช่วงที่ส่งต่อข้อมูลข้าม Node Quantize ข้อมูลจาก BF16 เป็น NVFP4
- ใช้ NVLink มาทำทางลัดการสื่อสารของ GPU GB200 ในเครื่องเดียวกัน
- V2 Overlapper คำนวณ Layer ถัดไปไปพร้อมๆ กับการดึง Weight เพื่อลด Idle Time เข้าใจว่า Model Runner V2 / Asynchronous Scheduling ของ vLLM
- แยก HW Node สำหรับงาน Prefill (4 Worker แต่ละตัว 2 GPU) และ Decode (1 Worker แต่ละตัว 8 GPU) ทำ Throughput ได้สูงสุดถึง 10,000 Tokens/sec ต่อ 1 GPU

การจัดการ Node (Orchestration)


- ปัญหา: ตอนระบบใหญ่ หรือ Scale บางทีงานมันหล่น หาย หรือ ไม่ได้เข้าไปทำงานที่ Node เดิม เสียเวลา Compute ใหม่
- วิธีปรับ: NVIDIA เสนอตัว Dynamo เป็น Framework ของตัวเองขึ้นมา มี
- KV-Aware Router / Session-Aware Migration
- PD Disaggregation
- Fault Tolerance
ทำหน้าที่คล้าย Ray แล้วมาจัดการ LLM Inference Backend ย่าง TensorRT-LLM / vLLM / SGLang / LLM-d
📚Resource: Slide


